Dự đoán phổ MS/MS bằng kiến trúc transformer
Phổ khối tandem (MS/MS) là nguồn dữ liệu quan trọng trong phân tích hệ protein, hỗ trợ nhận diện chuỗi amino axit, phân tích biến đổi hậu dịch mã và xây dựng thư viện phổ. Tuy nhiên, việc dự đoán cường độ phổ MS/MS từ chuỗi amino acid vẫn là một bài toán khó do phổ phân mảnh chịu ảnh hưởng đồng thời bởi trình tự amino acid, loại biến đổi, điện tích và điều kiện thí nghiệm. Trong bối cảnh đó, các mô hình học sâu, đặc biệt là transformer, là một hướng tiếp cận phù hợp nhờ khả năng mô hình hóa quan hệ dài hạn trong chuỗi amino acid, đồng thời vẫn chưa có đánh giá nào cho việc sử dụng transformer cho dự đoán khối phổ MS/MS, đặc biệt là có hậu dịch mã.
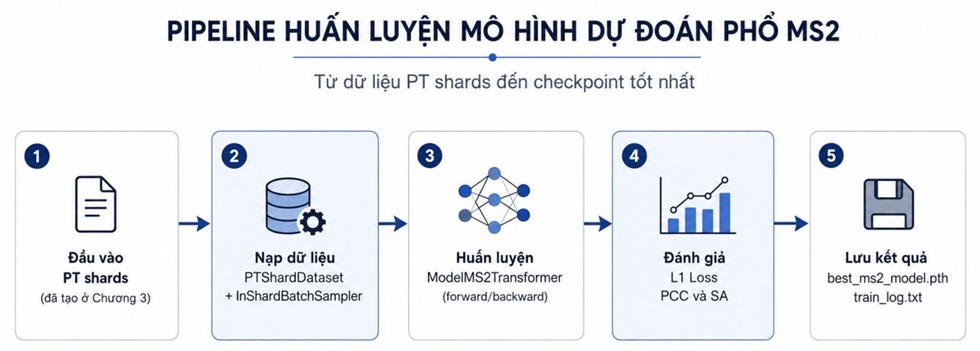
Khóa luận này nghiên cứu và triển khai mô hình dự đoán phổ MS/MS cho chuỗi amino acid có biến đổi hậu dịch mã dựa trên kiến trúc transformer. Nội dung thực hiện bao gồm xây dựng pipeline xử lý dữ liệu rất lớn, phân tích thống kê tập dữ liệu, thiết kế biểu diễn đầu vào cho amino acid, loại biến đổi và điều kiện thí nghiệm, huấn luyện mô hình transformer encoder và đánh giá kết quả bằng các chỉ số tương đồng phổ. Tập dữ liệu thực nghiệm sau xử lý gồm 2,000,000 phổ khớp (PSM), có độ dài chuỗi từ 7 đến 47 amino acid và tập trung chủ yếu ở các mức điện tích 2+, 3+ và 4+.
Kết quả thực nghiệm cho thấy mô hình có khả năng học ổn định trên dữ liệu đã xử lý. Trong thí nghiệm chính được báo cáo với 150 epoch, mô hình đạt hệ số tương quan Pearson (PCC) tốt nhất 0.8981 và góc phổ Spectral Angle tốt nhất 0.7819; tại epoch 150, PCC và SA lần lượt đạt 0.8953 và 0.7803. Bộ đánh giá siêu tham số cho thấy cấu hình 6 lớp transformer, lớp ẩn 320, kích thước lô 512, tốc độ học 0.0001 và tỷ lệ loại bỏ 0.1 là cấu hình tốt nhất trong không gian đã khảo sát. Các kết quả này cho thấy hướng tiếp cận transformer là khả thi cho bài toán dự đoán phổ MS2 trên tập dữ liệu phospho amino acid, đồng thời chỉ ra các giới hạn cần nghiên cứu thêm về khả năng tổng quát hóa, phân tích lỗi và đánh giá trên các miền dữ liệu đa dạng hơn.
Từ khóa: tandem mass spectrometry, deep learning, big data, post-translational modifications.
GitHub:
https://github.com/lucasdzio/tf-aiproteomic
https://github.com/digitalbiologylab/tf-aiproteomic
Lê Tiến Thực, tóm tắt khóa luận tại Trường Đại học Công nghệ, Đại học Quốc gia Hà Nội, 2026